ZeroCel
讓動畫師專注在最關鍵的畫格,把繁瑣重複的中割工作交給 AI——而且,主導權始終在人的手上。
⏸ 目前狀態:授權障礙已解除,但仍刻意暫不發行
產品面已可打包成自含式安裝檔並實際運行。原本擋住發行的是「AnimeInbet 僅授權非商用,而核心的 Hybrid 引擎以它為基線」——2026/08 這個障礙已經解除:量測顯示新版 RIFE 在大動作上已經全面勝過 Hybrid,那兩個引擎因此直接從產品移除,剩下的依賴授權全部乾淨。現在不發行的理由只剩一個:中割品質。目標使用者是靠作品吃飯的職業動畫師,在中割品質做到他們真的用得下去之前,我不想把一個「能跑但不夠好」的東西送到他們手上。決策過程見下方「授權評估」,研究進度見「現在的主線」與「未來展望」。
把勞力交給 AI,把藝術決策留給人
傳統手繪 2D 動畫一秒 24 格。動畫師畫的是原畫——動作的起點、最高點、落地點;中間的中割再補上去。三張原畫之間可能要補二十張,而那二十張幾乎沒有創作空間,純粹是體力活。這是最耗時、最重複,也最容易消磨創作熱情的環節。
近年的 AI 影格插值技術理論上能自動生成中割,但對動畫師來說有個致命問題:純自動化會奪走「意圖」的控制權。動作的快慢節奏、誇張與收斂、骨架的走向,這些都是動畫師的表演語言,不該交給黑箱決定。
ZeroCel 想回答的問題是:能不能讓 AI 承擔勞力,又把每一個藝術決策的最終決定權留給人?雙進程架構,CLI 與 GUI 平行客戶端
工作流:匯入原畫(PNG / PSD / 影片抽幀)→ AI 生成中間張 → 人工檢視修正 → 回饋自動學習 → 匯出 PNG 序列 / GIF / MP4。
整體採 C# WPF 前端 + Python FastAPI 後端雙進程架構,透過 HTTP REST(同步操作)與 WebSocket(推論 / 訓練進度推播)在本機通訊。前端啟動時自動偵測並拉起後端,前端結束時自動終止後端進程。CLI 與 GUI 被設計成後端的「平行客戶端」,彼此獨立而不互相依賴。
規模:C# 約 41,400 行 + 8,400 行 XAML;Python 後端約 26,800 行(39 個 API 端點);CLI 約 8,900 行;自研模型管線約 51,900 行;自動化測試四套全綠——後端 587 項、CLI 168 項、前端 436 項、自研模型 83 組自驗。
針對不同動作與線稿,兩個互補的推論引擎
原本有四個引擎,其中兩個在 2026/08 移除——不是因為授權妥協,而是量測顯示它們已經沒有存在的理由(見下方「授權評估」)。派工架構保留,被派工的對象未來會逐步換成自研模型。
| 引擎 | 原理 | 適用場景 |
|---|---|---|
| RIFE v4.18 | 光流插幀(PyTorch, IFNet_HDv3) | 平滑連續的小動作補幀,全彩/線稿通用,速度最快;支援 t 外推做 overshoot。 |
| TPS | 骨架控制點 + Thin Plate Spline 網格變形(scipy RBF) | 人物中割,支援部位鎖定與人工骨架編輯。 |
出貨版不做自動骨架偵測:開發期接過三種偵測後端(MediaPipe / RTMPose / DWPose),但那幾組骨架權重的授權站不住,2026/09 決定安裝檔不隨附、也不會自行下載。TPS 改由預設骨架範本起手,動畫師在畫布上手動拖點對位——同一條「授權有疑慮就不出貨」的標準,這次套在了配角身上。
AutoRouter 自動派工
純 CPU 邏輯、可獨立測試的決策核心:素材判定(依明暗比例、飽和度、線稿乾淨度分類)→ 動作粗估(取兩張前景墨線遮罩的質心,算歐氏距離並正規化到影像對角線:小動作與大動作都走 RIFE、髒線稿走 TPS)→ 輸出完整派工計畫。動畫師可以先預覽派工計畫、確認後才送推論——一鍵智慧調度負責省事,「進階面板」永遠保留完整手動控制。
派工以圖層為單位
推論不是對整張合成圖做的,而是逐圖層進行,派工只看該層的像素——角色層與背景層各自會拿到適合自己的引擎,而不是被整張合成圖的平均特徵拖著走。
整個過程不打斷工作流
訓練觸發自 2026/08 起預設凍結——回饋收集與推理計數照常進行,訓練本身等自研模型接上再打開。以下是這套閉環的設計。
隱式回饋收集
動畫師「鎖定 AI 原版/鎖定編輯版/刪除」的行為被記錄為訓練訊號,鎖定視為認可、刪除視為否決——不需要另外填任何評分。
自動排程與資源讓步
累積 ≥20 筆回饋、距上次 ≥6 小時、同日訓練 <2 次,於閒置時自動觸發(≥50 筆走緊急路徑,可 bypass 時間節流但仍須通過其餘檢查);動畫師一開始推論,訓練立即讓出 GPU。
Delta 增量訓練,不堆疊
三元組(A, GT, B);損失函數 2026/09 換成研究線驗證過的配方(位置損失 + 疊圖罰 + 對側報酬)。每次都從基底模型重新以 delta 增量訓練——不堆疊,避免個人化讓品質悄悄退步。
驗收 Gate 與三層 delta
每一次微調都要通過 holdout 考古題驗收——2026/09 起改為四把尺全過才採用(雜質、墨量、chamfer、抄襲),不再是單一的「相對改善 ≥5%」;首次微調沒有既有 delta,對照組即為純 base 模型。考題池建不起來時一律判定失敗,不放行。三層 delta 持久化:pending.delta(驗收中)→ active.delta(生效)→ previous.delta(rollback 用);上線後由 implicit gate 持續監控刪除率,突增則自動回滾。
⚑ 一個改對過的設計錯誤
初版的邏輯是「首次微調沒有對照組,所以免考直接套用,再靠刪除率監控」。聽起來合理,實際出了事故:首次免考 + holdout 池建不起來,等於把一個從未驗證過的模型直接套到使用者身上。修正是把「池空」從免考通過改成必定失敗,並讓首次微調的對照組取純 base 模型。「缺少驗證資訊時,預設該通過還是該失敗」是一道有明確答案的安全設計題——預設值要落在保守的那一邊。
動畫師的控制權,落實到每一層
| TimelineView / VM | 多軌時間軸、FPS、曝光格(右鍵直接建立)、多選框選、音軌波形(NAudio)與對齊。 |
| CanvasView / VM | 繪圖工具:自建筆刷引擎、圖層樹(遮罩 / 資料夾)、濾鏡、選取、尺規與對稱尺、透寫台、快速遮罩;洋蔥皮疊加、縮放平移、骨架編輯模式。 |
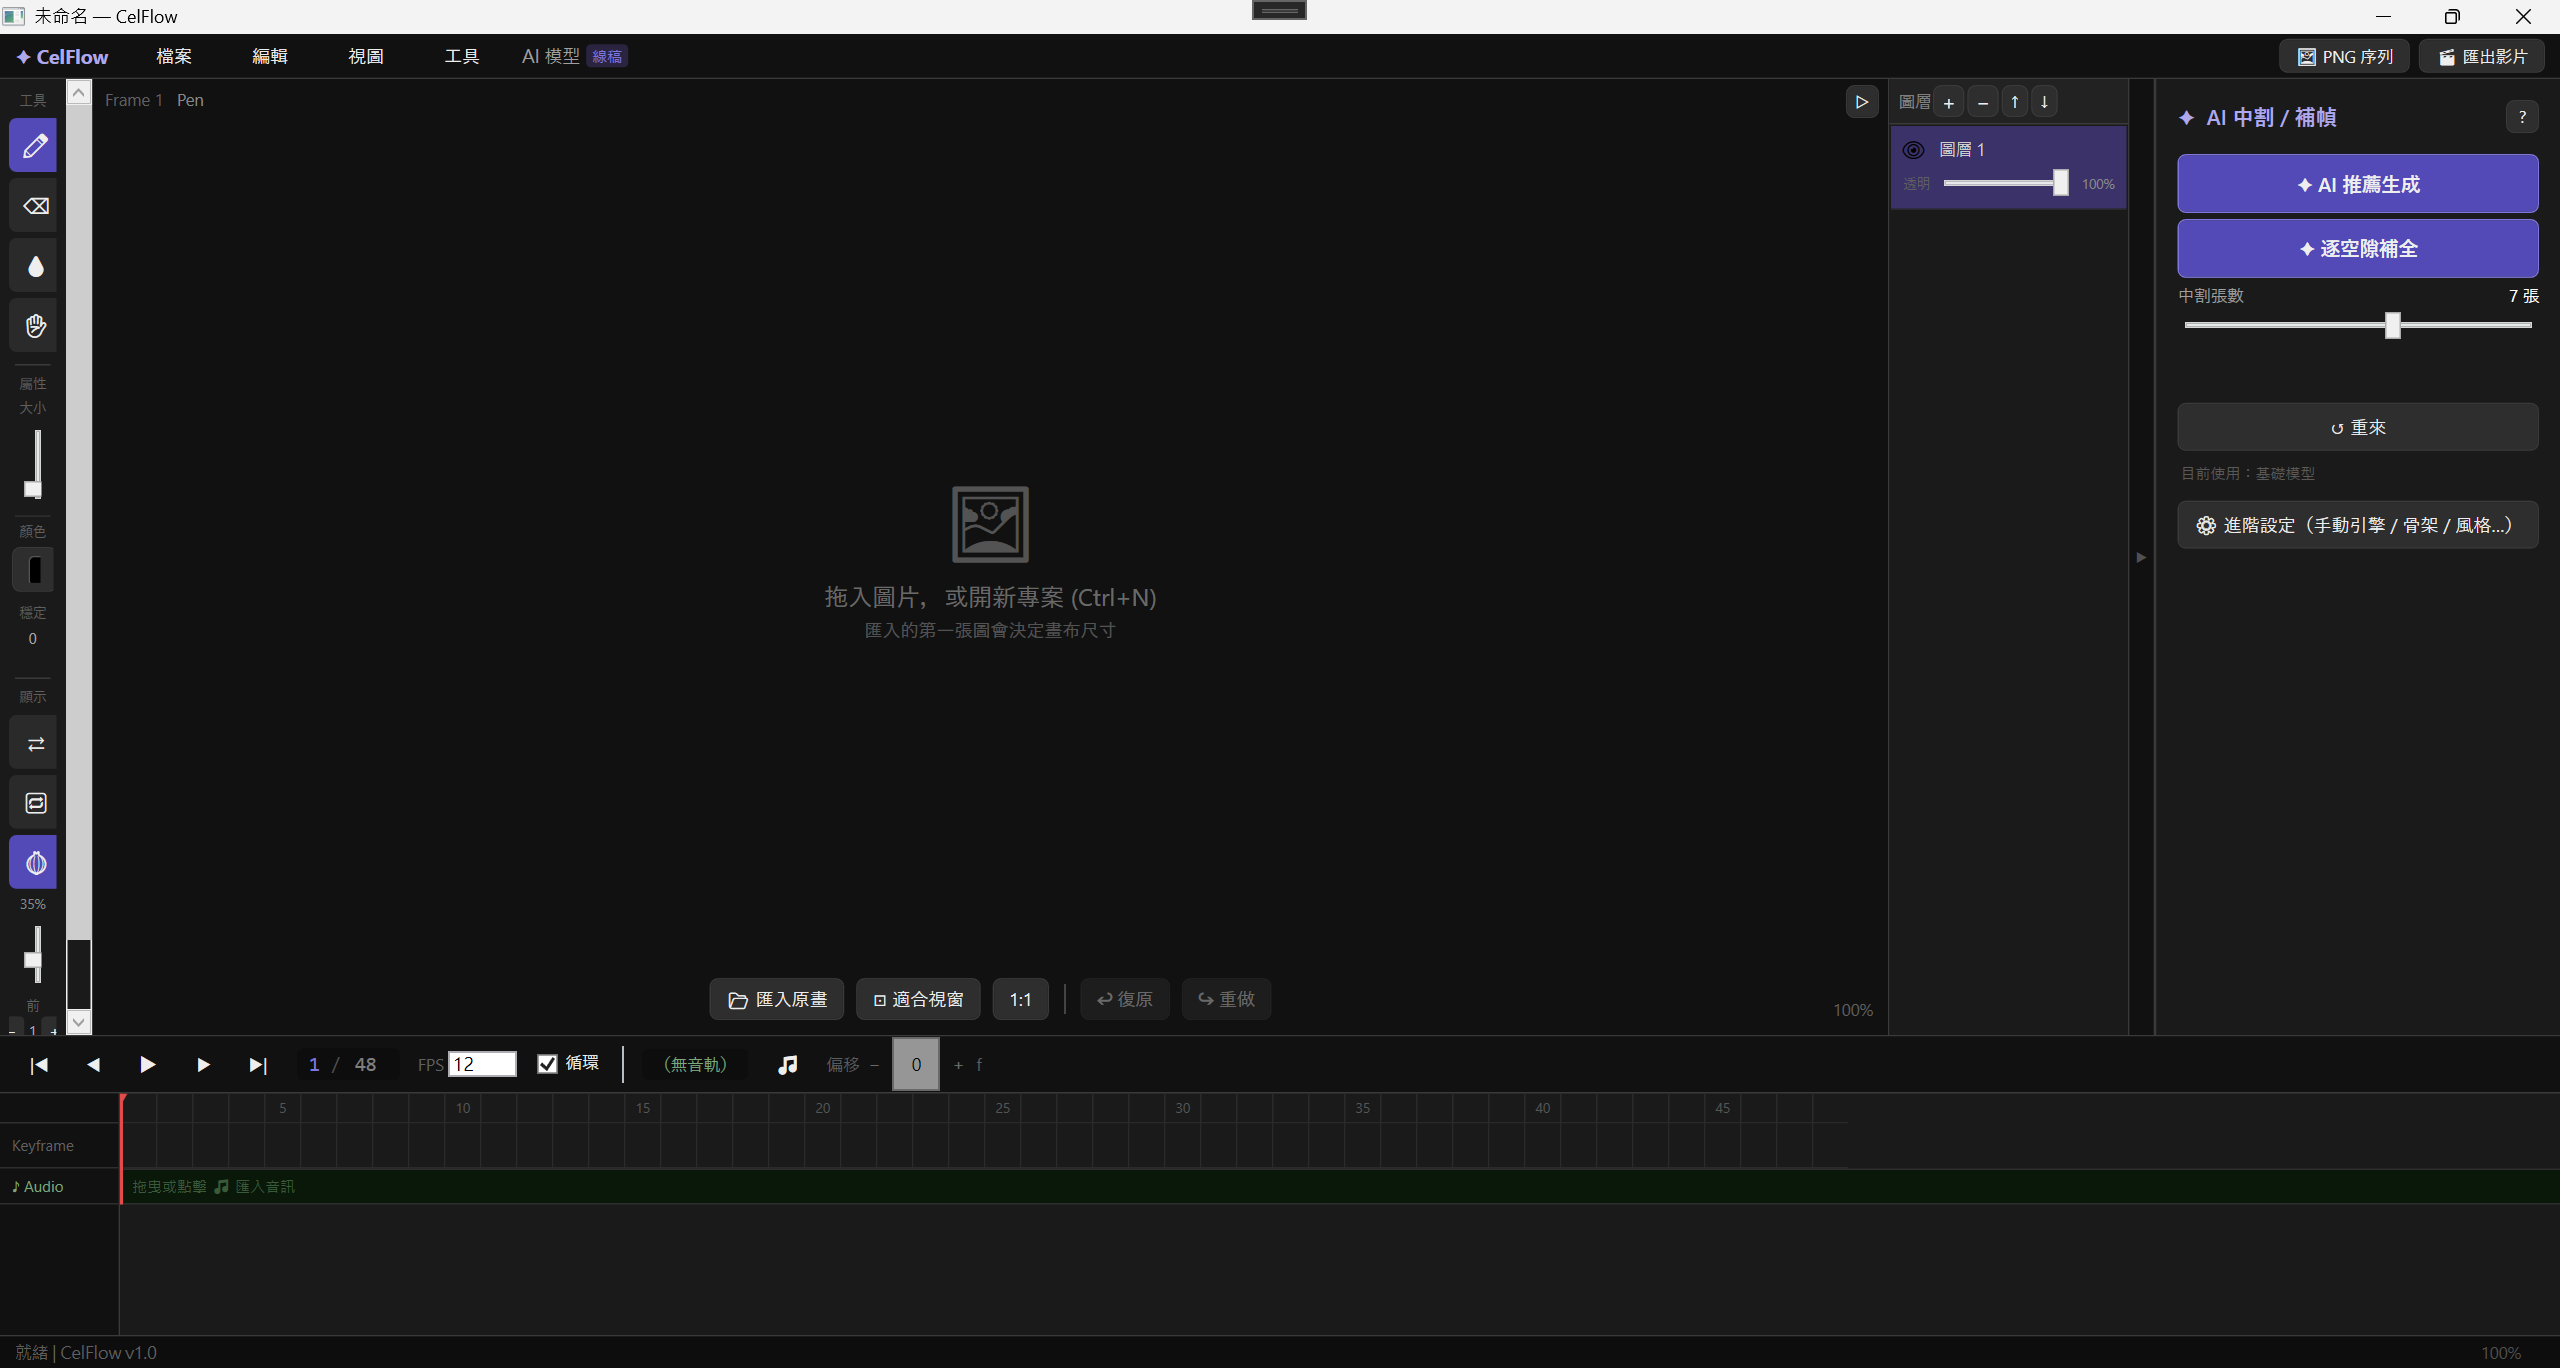
| 工作區版面 | 左工具條 / 上屬性列 / 右停靠區四分頁——AI 中割(推論會話、引擎 / 模型選擇、骨架編輯、中割風格曲線)收進停靠區分頁,不再獨佔一欄;快捷鍵可自訂。 |
| AI 拆層 | 把一張畫拆成主角 / 其他人物 / 物品 / 背景四層,並補全被遮住的背景。 |
| 匯入匯出 | 影片抽幀與 PSD 分層匯入、MP4 / GIF 匯出、批次匯出視窗;成品旁附逐格履歷,標明每一格是人畫、AI 生成、AI 生成後人改過,還是補格。 |
| 微調管理 | 模型切換、微調清單管理、個人化參數與排程狀態。 |
骨架關鍵點鎖定 + 手動編輯
六組可勾選的部位(頭部 / 左臂 / 右臂 / 軀幹 / 左腿 / 右腿)+ A/B 錨點,在畫布上以骨架疊圖即時呈現,動畫師可逐點開關;TPS 引擎依鎖定點保持該部位不變形。骨架節點由動畫師直接在畫布上拖拉對位,引擎依人工座標變形。
中割風格系統
Smooth / Exaggerated / Mechanical / 自訂 Bezier 曲線(BezierEditorView)直接對應動畫表演的不同節奏,轉為自訂 t_values 送後端。
Quick Flip · 模擬手翻紙檢查動作
按住 F 鍵 ±2 格鐘擺播放,模擬動畫師手翻紙檢查動作。
失敗要明講
推論輸出接近空白時(大動作下確實會發生,量測見下節),介面直接提示「動作幅度可能過大,建議改用其他引擎或手動處理」,而不是默默交出一張白圖。動作大到補出來的線容易變淡時,也會提醒「建議在中間多放一張原畫」。
DrawingId 中心的儲存
LayerStore(各圖層像素,真相源)+ FrameStore(合成快取)分離。動畫的「一拍二」「一拍三」意味著同一張畫會曝光在多個格子上;若以格號當識別,同一張畫會被複製多份、編輯時就會不同步。改以 DrawingId 索引後,改一張畫則所有曝光到它的格子同時更新——這與動畫師的曝光表心智模型一致。
.zcel 專案格式 + 自動存檔
ZIP 容器內含 project.json、圖層 PNG、音軌、可選微調 delta.pt(載入時逐 entry 驗證路徑,防範 Zip Slip)。操作計數 + 閒置計時雙觸發、雙緩衝(autosave.zcel + .bak)、CrashRecoveryDialog。
從實驗到交付的完整鏈路
CLI 平行客戶端:中割生成、批次處理、匯出影片都能不開 GUI 完成。
打包發佈:自含式安裝——內嵌完整 Python 環境 + 全部套件 + 模型檔,使用者免裝任何依賴;以 Inno Setup 產生單一安裝檔並附已知限制說明,一鍵指令即可完成改版重建。安裝檔隨時可產出,暫不對外發行的理由見下方「授權評估」。
研究區:產品背後的實驗與訓練場——SIGGRAPH 2024 線稿向量化與 ICCV 2023 線稿中割論文的實作與再訓練,早期產品引擎的權重即出自這裡;各實驗環境彼此隔離,不污染產品環境。這條線的產出技術上有效,但商業上走不通,它現在的定位是自研模型的對照基線與經驗來源,而非產品的未來。
自研中割模型:追平了現役,也量清楚了牆在哪裡
目標是訓練一個吃真實手繪三元組、能在任意時間點生成中割的自有模型。訓練樣本是(原畫 A, 手繪中割, 原畫 B)+ t,而 t 取自律表上的真實格號——這是唯一能告訴模型「這張中割落在動作的哪個時間點」的資訊。
真實素材到位前,先用程序化合成資料(3D 骨架 → 線稿渲染,含轉面遮擋)把整條訓練管線驗證過一輪:花費 US$0、全在本機、給定 seed 完全可重現。職業動畫師的手繪素材到位之後,第一刀改成只用真料訓練。
合成料這一輪最有價值的產出不是模型,是三次推翻自己的結論。指標本身要先用構造出的已知答案驗證過,才能拿它做決策
主指標(F1@2px)對「把墨塗滿」是加分的——早期看到的「進步」全是塗抹換來的。後來又抓到兩次:把線訓成點陣,chamfer 和 F1 都給它全場最高分;一條 1 px 的灰帶,騙過 chamfer 兩次。
同一個 epoch 數在不同資料量下意義完全不同
沿用產品端的 epoch 數,實際每個樣本只跑了 4 步梯度(單樣本收斂需 ~400 步)。該看的是每樣本步數。
我以為是順序問題,結果不是
三種控制訊號全被模型無視;量測後發現模型自身誤差(3.2)是該分辨訊號(0.93)的三倍多。當時我判斷這是順序問題——先把模型練準,再教控制。第一刀做完,回頭用同一把尺量,這個比例完全沒變小(第一刀和現役幾乎一樣),第二刀照樣教不動,原因也不是順序(見下方「未來展望」)。
「補足步數」走過頭,畫面就髒了
8 月我說要補足每樣本的步數。真料上量到另一端:步數越多,線上的碎點雜訊越多——走 300 步和現役一樣乾淨,1,200 步多 30%,走完 2,690 步約 2.5 倍。料從 393 筆加到 3,499 筆、同樣只走 300 步,結果一樣。料多沒有用,第一刀的天花板就是和現役一樣乾淨。
機器尺上的進步,職業動畫師不一定看得到
我做了一把量「抄原畫」的尺,模型第一次在上面進步了。拿去給職業動畫師盲測:現役 RIFE 20 分,我的兩個版本各 4 分(滿分 40)——評語幾乎都在講畫面上的碎點雜訊。把雜訊壓到和現役同級再考一次,被點名「有雜質」的題從 12 題降到 2 題,但講「抄原畫」的評語兩邊一樣多(4 對 4)。尺量得到,不代表人看得到;雜訊是第一道門。
給模型一條路,它不一定會走
第二刀把骨架訊號接進模型,訊號在模型裡的比重從不到 1% 拉到 32~80%。但給它對的骨架和故意平移過的錯骨架,輸出比較好的機率只有 42~47%——跟丟銅板差不多。拆開看,那條支路學成了一個常數:把骨架整個換成空白,輸出只差 5.8%。兩張原畫本來就推得出中間張的大半,模型沒有理由去讀骨架。
目前站得住的結果:第一刀在 RIFE v4.18 上只用真料微調,在職業動畫師盲測裡第一次不輸現役——20 題、每題 0~2 分,第一刀 18 分、現役 16 分、人畫的正解 36 分。差 2 分落在這份卷的雜訊帶(±4)之內,所以是持平,不是贏;上一回被嫌雜訊的舊版本放進去當對照,只拿 3 分,評分標準沒有放鬆。按難度拆:簡單 8 對 6、中等 7 對 7、難 3 對 3;最大動作那幾題,三個 AI 版本全是 0 分。目前出貨的仍是原版 RIFE v4.18。
(8 月這裡寫過「大動作 ok 率 40.3% → 50.7%」。那個數字量在合成料上,而且原始設定沒存下來、照文字重建只跑得出 40.3%,已撤回。)
線稿塌陷
純像素損失在線稿上會讓微調後的模型輸出全白——因為線稿 99% 是白底,「交白卷」就是損失函數的最小解。陰險的是訓練 loss 一路下降、SSIM 甚至上升,只看曲線完全發現不了。當時的修法是墨線加權;9 月微調配方換新之後,改由損失函數內建的墨量下限、訓練後自檢、驗收閘門三道把關。
默默交出白圖
量測發現當時的底模在合成料的大動作上有 15% 的輸出幾乎空白、41% 線量嚴重不足(非大動作則為 0%),而推理路徑對此完全沒有檢查。現已在輸出接近空白時主動提示動畫師。
透明圖層上的中割,其實是淡入淡出
研究一直在白底上量中割,產品的圖層卻是透明底。實測發現,只要圖層是透明底,產品的 AI 中割就等於兩張原畫交叉淡化,匯出影片時透明處還會變黑。同一天修好:透明度改成跟著動作走。
動作一大,線就變淡
合作的動畫師提醒「不要把線私自拉直」。我去量了:線沒有被拉直,但量到另一個問題——動作一大,補出來的線就變淡,線量只剩手繪正解的六成五左右,117 題大動作裡有 13 題線幾乎整個消失。現在動作很大時,介面會提醒「建議在中間多放一張原畫」,安裝檔附的已知限制說明也寫了。
這四個缺陷都是在研究線量測出來、回頭修進出貨程式碼的;第三個還是量法本身的盲點——研究量的路徑,跟產品實際走的路徑不一樣。產品端的派工架構會保留,底下的模型最終要換成我們自己做的。RIFE 是 MIT 授權,這不是授權問題,是希望產品裡的每個模型都出自自己的手。
最花心思的不是接模型,而是這幾個架構決策
引擎分離,而非單一引擎加開關
不同引擎對線稿乾淨度的需求是相反的,硬塞進同一個引擎用旗標切換,只會埋下難解的耦合。
兩層調度分得很清楚
粗粒度的「該用哪個引擎」(L1,AutoRouter)與細粒度的「引擎內部該用哪個 backend / 尺寸」(L2)是兩件事,刻意不混為一談——否則「換個骨架後端」會意外改變引擎選擇。
一鍵介面藏的是工程決策,不是工作流
把使用者不該煩惱的引擎選擇收起來,但動畫師真正該擁有的創作控制權一個都不能少——收進「進階」摺疊區,需要時隨手展開。
自動微調採三層 delta 與驗證閘門
每次都從基底模型重新訓練(不堆疊),通過驗證才切換,確保個人化不會讓品質悄悄退步;缺少驗證資訊時預設失敗而非預設通過。
合成訓練料一律不進 holdout
考卷必須是真人手繪——合成料的標準答案是數學算出來的,對模型過於友善,混進去分數就不代表任何東西。這條紀律寫成了程式檢查,違反會直接拋例外。
為什麼一個做完的產品,被自己按住不發
產品完成度到達可打包發佈後,我對每一個依賴做了授權查核,當時的結論是不能出貨:
| RIFE | MIT(hzwer/Practical-RIFE)— 商用無虞 |
| AnimeInbet | ICCV 2023,程式碼僅限非商用 — ✗ 不可商用 |
| MixamoLine240 | 訓練 AnimeInbet 用的資料集,CC BY-NC-SA 4.0,且素材源自 Mixamo——Adobe 條款明文禁止其內容用於任何機器學習系統的訓練 — ✗ 雙重禁止 |
問題在於 AnimeInbet 不是可有可無的附加功能:核心的 Hybrid 引擎以它為基線,拿掉它等於拿掉大動作線稿中割的主力。評估過三條路——洽原作者取得商業授權(即使談成,核心能力仍架在他人授權上)、做一個「商用模式」降級開關(等於出貨一個主力功能被閹割的產品,而使用者不會知道為什麼),以及自研模型全面取代(工程量最大、時間最久)。選了第三條,並決定取代完成前不對外發行。
2026/08,答案來自一個沒被列進那三條路的方向:量測。把手上所有引擎放到同一批真實線稿上做對照,結果是 Hybrid在全區間都輸給新版 RIFE,而且它有 16% 的骨架偵測失敗率、RIFE 是 0%。換句話說,那個「不可取代的主力」早就不是主力了——它只是沒有人回頭量過。兩個引擎因此直接從產品移除,授權障礙隨之解除,剩下的依賴(RIFE,MIT)授權乾淨。
所以現在按住不發的理由換了一個,而且更單純:品質還不夠。自研模型的目的也跟著變了——它不再是「為了合法而不得不做的替代品」,而是「為了把中割做到職業動畫師真的用得下去」,以及讓產品裡的模型最終都出自自己的手。
授權問題是被量測解掉的,不是被繞過的。前後端分離的具體組成
| 前端 | C# .NET 10(WPF)· CommunityToolkit.Mvvm · DI(Microsoft.Extensions)· NAudio · NLog |
| 後端 | Python 3.14 · FastAPI · uvicorn · PyTorch(CUDA)· ONNX Runtime · OpenCV |
| AI 引擎 | RIFE v4.18(光流,MIT)· TPS(骨架變形,自研實作)· isnet-anime(AI 拆層,rembg 發佈的 ONNX 權重,安裝檔內附授權檔;過渡件,自研接上後替換) |
| 骨架 | 預設骨架範本 + 畫布手動拖點(自動偵測的權重授權站不住,出貨版不隨附) |
| 測試 | pytest:後端 64 支檔案 / 587 項(API、派工邏輯、拆段、版本等價性回歸、模組接線)· CLI 11 支 / 168 項;xUnit:前端 436 項;自研模型 83 組自驗 |
| 檔案格式 | 自訂 .zcel 格式(以 ZIP 為基礎) |
| 發佈 | Inno Setup + 內嵌 Python(自含環境)· 一鍵重建腳本 |
先找到畫得出「中間那一張」的做法
自研模型第一刀:通用取代——做完了,追平現役
在 RIFE v4.18 上只用真實手繪料微調,職業動畫師盲測持平(見上方「現在的主線」)。機器尺上的天花板也一樣:雜訊和現役同級就是頂,加料沒有幫助,加步數只會更髒。8 月我寫它「在間距十幾格的中等動作上輸給直接複製原畫」——那是更早一版、混了合成料的模型,題目也只來自一顆鏡頭。第一刀在兩張原畫相隔 7 格以內的題上,線的位置誤差中位 1.79 px,直接複製原畫是 3.40 px;間距十幾格那批題我還沒重量,所以不說它翻過來了。
這一刀能做的已經做完,而它撞到的是架構本身:RIFE 的輸出,在數學上就是兩張原畫各自搬移之後的加權混合。搬對了位置就是一張中割,搬不對就是疊影和抄襲;姿勢一大,搬法就算不準。合作的動畫師一再強調(講過不只五次),中割要和兩張原畫都不一樣:剛體的位移、縮放可以內插,姿勢、衣服頭髮這類次級動作不行。
自研模型第二刀:控制條件化——四條路走完,結案
目標是讓中間張的姿勢跟著動畫師指定的骨架走,取代現在的 TPS。四條路依序走完:改接法(訊號接得進去,模型不讀,見上方);改損失(直接罰「不服從」,罰不動,還有一顆隨機種子學會在給骨架時交白卷);加料與預算(步數放大 10 倍,訓練損失掉四成、測試分數一動不動;換成難料更糟);硬約束(不靠學,直接照骨架把原畫搬過去——搬得準,但線被扯爛:線量變兩倍、碎成四倍多塊,因為角色在大動作裡移動幾百像素,要搬的範圍佔了畫面約七成)。
結論:小動作的格子,兩張原畫就推得出中間張,骨架用不上;大動作的格子,要搬的幅度等於重畫,搬像素必然把線弄壞。所以不是「現在還教不動」,是「搬像素」這個做法在這裡兩頭都不成立。10 月用動畫師親手標的骨架補量了上限:關節移動超過身體大小約 14%,搬原畫就多半毀畫——骨架幫得上忙的「中等動作」,在現有素材裡只是很窄的一帶。
這一刀最貴的一課:同一個設定換三顆隨機種子,主判準讀到 11%、44%、89%。只跑一顆,我會宣告成功,或宣告控制訊號有害。之後的結論一律報全部種子的範圍。
生成式:現成的照原樣不行
既然搬像素到頂,下一題是:換一種會「重畫」的模型呢?我拿兩個公開的生成式模型——一個專做動畫中割、一個是通用影片模型——當探針,只量、不進產品,也不拿它們的輸出當訓練資料,在 38 題線稿中割上和 RIFE 比。兩個都沒有比 RIFE 更會畫「只有中間才有的線」(找回率 0.21 對 0.19、0.19 對 0.16,都不顯著),線畫錯位置的情況卻多很多(精確度只剩 RIFE 的五到六成)。典型的失敗是把 A、B 兩張原畫的角色同時畫在原位,或乾脆換成另一個角色。現成的照原樣用,和混合一樣沒畫出中間那一張。
下一步是在自己的素材上小幅微調其中一個再考一次,還是直接自己做一個生成式模型,還沒決定。順序不會變:先確認哪一種架構畫得出來,再把那一種做成自己的。
離「可以發行」還差在哪
最近一次盲測只考現役引擎:它補出的 40 格中割,職業動畫師判 22 格要動手。可以直接用的 18 格,全是平移、縮放、小動作;要動手的,全在跳躍、脫帽、盪鞦韆、打鬥這幾顆大動作鏡頭。這就是還不能發行的地方——不是平均分數不夠,是動作一大就得整格重畫。(同一位評審前後判同一題,5 題裡 3 題一致,所以 22 / 40 只是這一次的讀數,不是穩定的比例。)
在找到會畫的模型之前,我在校一把尺:看它能不能在一顆鏡頭裡,標出最需要動畫師親手處理的那幾格。校得準的話,它可以變成產品裡的提示——至少讓工具誠實。
跨平台:暫緩
原本規劃以 Avalonia UI + SkiaSharp 重構介面、延伸到 iPad / Android,這個規劃已經擱置。先把 Windows 版的中割品質做到能發行;之後真要擴平台,優先是 Mac。
Windows 自含式安裝檔(Inno Setup,內嵌完整 Python 與 AI 推論環境),兩種形態:完整版內含 PyTorch;瘦身版不含 PyTorch、中割改走 ONNX(與完整版逐像素差 ≤ 1/255),代價是不能自動微調。技術上隨時可產出,但目前刻意暫不發行——授權已乾淨,等中割品質達標。